Tag: JPN Academic

Analytics | Students & Educators
0
本当の原因は何か?:コラム概要

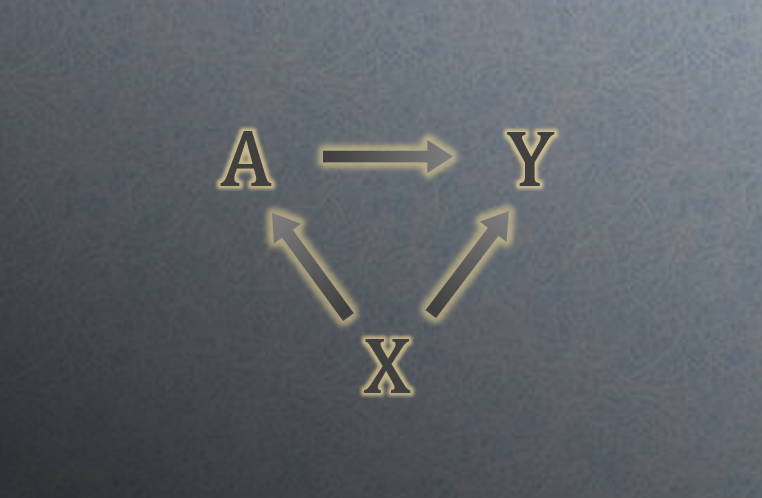
はじめに   根拠に基づいた意思決定を行うこと (EBPM; Evidence Based Policy Making) が、近年分野を問わず重要視されるようになってきています。意思決定を行う立場としては、根拠となる事象と結果の事象の間に因果関係があるのか、それとも相関関係しかないのかは大変大きな違いです。   因果関係と相関関係を混同した1つの有名な例として、チョコレート摂取量とノーベル賞の受賞者数に関する研究があります。この研究では、「チョコレートを多く摂取するとノーベル賞受賞者数が増加する」という因果関係の存在について触れられています。この論文は、2012年に世界で最も権威のある医学雑誌の1つである New England Journal of Medicine に掲載され、世界規模で大きな論争を引き起こしました。論文では、国ごとのチョコレート消費量とノーベル賞受賞者数を調べたところ、チョコレート消費量の多い国ほどノーベル賞受賞者数が多いというデータが示されました。論争のポイントとなったのは、各国のチョコレート消費量とノーベル賞受賞者数の関係が以下のどちらの関係であるかについてです。  チョコレートを摂取すればノーベル賞受賞者は増加する(因果関係)  別の隠れた要因がそれぞれに影響を与えており、チョコレート消費量とノーベル賞受賞者数の間に見かけ上の関連性が生まれている(相関関係)   一体どちらの主張が正しいのでしょうか。読者の方には、ぜひ今の意見と、このコラム連載が終了した後の意見を比較していただきたいと考えています。   統計的因果推論 (Causal causal inference)  とは、因果関係をデータから導くための体系的な学問領域であり、2021年に David Card, Joshua Angrist, Guido Imbensの3名がノーベル経済学賞を受賞したことも相まって、現在大きな注目を集めています。しかし、その注目の程度と比べると、内容についてはあまり認知されていないように思います。そこで本ブログ・シリーズでは、統計的因果推論(または、単に因果推論)に関する連載を行います。データアナリティクスに関わる多くの方に、因果とは何か、それをデータから導くためには何が必要となるのかを理解をしていただき、適切なデータアナリティクスのために活用されることを望みます。連載コラムで取り扱う内容は以下を予定しています。  理論編 潜在アウトカムの枠組み 因果効果を求めるために必要な条件 観察研究と実験研究における交換可能性 選択バイアス (selection bias) 測定誤差 (measurement error) 手法・実装編 推定におけるモデルの必要性 層別化・回帰・標準化 傾向スコアとそれを用いた手法 操作変数法  理論編では、データから因果関係を考えるために必要となる概念、および仮定について取り扱います。また、観測される関係が真の関係と異なる要因について解説を行います。手法・実装編では、理論編で扱う潜在アウトカムの枠組みで因果効果を推定する手法についてSASでの実装方法とともに紹介を行います。SASソフトウェアでは、2016年以降のバージョンで、因果推論に特化した機能が利用できます。   なお、手法・実装編で紹介する因果効果の推定手法は、すべてを網羅しているわけではなく、回帰不連続デザインなど他にもいくつかの手法があることにご注意ください。 本コラムでは出来る限り数学的な記載は避け、直感的な表現をすることに努めますが、数理的な部分に興味がある方に向けた参考資料も準備しています。コラム中に登場する解析例で使用したプログラム・コードは著者のGithub上で公開を行う予定です。    謝辞  この連載記事では、参考文献として主に以下の2つを使用します。 Causal
Analytics | Data for Good | Students & Educators
0
あなた自身の「好奇心」に耳を傾けよう

Curiosity Forever SASは約束します。データの探索や、アナリティクスそして学習、これらの進化を止めません。好奇心と能力が出会う時、世界は前進するからです。 SASは、”Curiosity=好奇心”から生まれるユニークで大胆な問いに対して、アナリティクスを用いて解を探すことを大切にしています。これまでにも自然やウェルネス・教育・スポーツなど多岐にわたる分野の好奇心溢れる問いに取り組んでいます。そしてこのCuriosity Foreverを、現代の子どもたちが体験できる環境を築くことが、私たちの未来を豊かにすると考えられます。 データネイティブの世代を育てる準備ができていますか? 1990年代半ばから2000年代前半に生まれたZ世代は、これまでで最も多様性に富み、最も教育水準の高い世代であり、社会変革の原動力として位置づけられています。2014年、Monica Rogati氏は データネイティブという言葉を作り、「データネイティブは、自分たちの世界がスマートで、自分たちの好みや習慣に一貫して適応することを期待している」と述べました。データネイティブの子どもたちは読書量、成績、スクリーンの使用時間などを記録するようになります。スマートで、プログラム可能で、データが豊富な世界で育ちながら、彼らは毎日データに浸かっていると言えるでしょう。 Z世代が社会で活躍する時代の到来とともにテクノロジーも進化し、私たちは膨大なデータを持つことになります。データはこれまで学術研究や政府の政策など、社会の一部に限定されたツールでしたが、今や主流になりつつあり、専門家だけでなく全ての人がデータリテラシーを身につけることが不可欠です。 若者がデータリテラシーへの関心を高める鍵は、生徒が関心を持つ問題にデータリテラシーを結びつけることにあります。これまでの学校教育におけるデータは、数学などの科目でデータの基礎として扱われることが多いです。しかしデータの活用が出来る分野には、社会的不公正との戦い、環境保護、飢餓との戦いなど世の中の実際に起こっていること・子どもたちにも身近なことに広がっていて、それらを通じて若者の生来の情熱に訴えかけることができます。また、データがどのように責任を持って使われ、進歩やイノベーションを促進するのか、子どもたちに伝えましょう。それと同じくらい重要なのは、データサイエンスの分野に自分たちが反映されていることを確認することです。この分野への参加を広げ、多様性を高めることは、社会的格差の縮小に取り組む上で最も重要なことです。 わたしたちはデータに慣れ親しむZ世代の探究心や情熱とともに、私たちは創造性と革新性を育む環境を育み、社会全体をよりよい方向に進めていく必要があります。 ※このセクションはAre we prepared to raise a generation of data native?の内容を要約しています。詳細はこちらをご参照ください。 Curiosity: 東京は暑い! 筆者もZ世代の学生として、好奇心からアナリティクスにつながるちょっとした体験をしました。 上京してきた際に「東京って思ったよりも暑いんだ」と感じてから、都市部の暑さに興味を持ちました。近年、夏に注意を促される熱中症。毎年患者数が増加しており、日本全体で暑さに関する対策として緑のカーテンなど緑化を行っています。しかし、その緑化はどれくらい効果があるかピンとこない気がしていました。そこで今回は仮説として、「緑地率が高い区ほど熱中症患者数が少ない」を立てたので、東京都23区の緑地率と熱中症患者数にどのような関係があるかについて確かめたいと思います。 上図は、年次ごとに東京都23区の100万人当たりの熱中症患者数と緑地率(AVNIR-2の光学センサの衛星データより緑地を抽出して求めた割合)の相関を確かめるために作成した散布図です。 散布図から、6年分全体でみて緑地が増えると熱中症患者が減るという傾向は読み取れませんでした。相関係数0.4と正の方向に相関が少し出ていますが、年次で色分けした部分で縦軸方向に層ができているように見えるので、相関係数のみで判断するのは難しいと考えました。また区ごとに時系列で比較したとき、たった6年で緑被率に大幅な差がありました。これは私が取得できた衛星データに雲がかぶっているなどの原因で、緑地率のデータが正確でないためである可能性もあります。 今回の観察期間で熱中症患者数は年々増加しており、機会があれば、緑地率以外に考えられる要因を集めて影響度を確かめてみたいと思いました。 このように日常生活でふと気づいた疑問を積極的に考えて、実際はどうなんだろうか、何か出来ることはないかとアナリティクスを用いる動きは、学生の好奇心を刺激しデータ活用の第一歩となります。学生の皆さん、いま浮かんだ疑問をデータを使って深掘りしてみませんか? What are you curious about?

Analytics | Students & Educators
0
データアナリティクスにおける統計学の必要性

現代において統計学は様々な分野で利用されており、データアナリティクスとは切っても切れない関係にあります。しかし、実際にデータアナリティクを行う人すべてが、その内容を適切に理解しているのでしょうか。「有意差がつくかどうかとりあえず検定を行ってみる」、「集めたデータ全てをモデルに組み込んでみる」このような経験を持つ方も実は多いのではないでしょうか。分析に用いる手法の仮定や限界、その他解釈や留意事項への理解がないまま行われるデータアナリティクスは、誤った解釈を生む可能性があります。しかし、実社会においては、統計学はその活用事例が注目されがちであり、適切ではない事例が身の回りにあるというのもまた事実です。データアナリティクスを行う側としても、その結果を受け取る側としても、統計学を一般教養として学んでみてはどうでしょうか。 今回紹介するのは、e-learningコース「Statistics 1: Introduction to ANOVA, Regression, and Logistic Regression」です。統計学を学ぶ時に、学習がうまく進まない一つの理由として、各種内容が実際にどう活用されるか、そのイメージがつかないという声を多く耳にします。本コースは純粋な統計学の知識だけでなく、そのような具体的なデータアナリティクスに至るまでの「何を目的とするのか」、「目的によってどのような手法が適切であるのか」といった「データリテラシー」に関する内容も潤沢に用意されているため、一環した流れの中で学習を行う事ができます。このような何のために統計学を学ぶ必要があるのかという点は、どうしても”学問としての”統計学の学習の際には意識がされないため、統計学を初めて学ぶ方だけではなく、簡単にその内容を触れたことがある中級者の方にも最適な学習教材です。 統計学は「記述統計学」と「推測統計学」に分類されます。前者はデータの持つ特徴(最大値、平均など)を記述し、整理することによって、そのデータ自体への理解を行おうというものです。それに対し後者は、データをとある大きな集団からのサンプルであると仮定し、データからその大きな集団(母集団)の持つ特徴について、推測を行うものです。ここでは、実際に推測統計学でよく用いられている「統計的仮説検定」と「統計モデル」という、2つの手法について紹介します。これらについてもコース中ではより詳細に、活用されている事例とともに紹介されているので、ご興味のある方はぜひ一度コースに登録・受講してみてください。登録手順はこちらの以前の記事を参照ください。   統計的仮説検定 ある大きな集団(母集団)に対しその特徴を知りたい場合、すべてのデータを得ることができるのは非常に稀です。例えば、日本国民全員があるテレビ番組Aを見ているかどうかの情報を得ることは、労力的にも、費用的にもほぼ不可能です。統計的仮説検定はそういった場合に、標本である一部のデータを用いて、母集団に対する特定の仮説が成立するか否かを、背理法的に判断する方法です。先のテレビ番組の視聴率調査は、実際にこの考えに基づくものであり、よく見かける視聴率はおおよそ1万世帯のデータをもとに、統計的に推定されています。検定の手順は以下の通りです。 母集団に対し、帰無仮説とそれに対応する対立仮説の計2種類の仮説を設定する 帰無仮説の下で、得られたデータ(とそれ以上に極端な結果)が得られる確率(P値)を計算する 事前に設定した基準(有意水準)とその確率を比較する 基準よりも確率が低いのであれば、そもそも帰無仮説が妥当ではないと判断する(帰無仮説を棄却) 統計学でよく誤解を生みやすい「P値」というものが利用される内容になります。仮説検定は非常によく用いられる方法ですので、自分でどういった手順で検定は行われているのか、その解釈はどう行えばいいのか、を説明できない方は受講してみることをお勧めします。   統計モデル データから母集団の特徴について推定を行う場合には「統計モデル」というものが用いられます。このモデルはなぜ必要なのでしょうか?ここで、日本人の男性と女性の身長について、それぞれ推測をするという例を考えます。また、現実に得られるデータは、男性のみデータだけだとします。すると一つ問題が生じます。それは「女性については推定を行うことができない」ということです。男性については、得られたデータが男性50名の身長データですので、妥当な推定が可能です(ここにも男性の身長分布は正規分布であるという仮定は置きます)。しかし、女性の身長について推定を行おうとしても手元には男性のみのデータしかないため、推定ができません。もし何の仮定もなければ、男性の身長データを女性の身長の推定のために用いることは妥当ではありません。ではここに、『女性の身長の分布は男性の分布より10cm低く、分布の形状は同じである』という仮定があるとどうでしょうか?(いくつかの調査によると期待値としては12~13cmほど低いそうですが) 上記の仮定があるのであれば、男性の身長分布から女性の身長分布が想定可能なので、男性のみのデータからデータには含まれていない女性についても推定を行うことが可能になります。つまり、「統計モデル」とは観測されたデータにはない未知の部分について推測を行うために、仮定する一種の数学的・統計学的な制約条件になります。ただ一概にモデルといっても様々なものがあるため、データの置かれている状況によって想定される適切なモデルは異なり、どれを選択すべきかはケースバイケースです。このモデルの選択をどうすべきかは先行研究やこれまでの知見による部分が大きいため、様々な場面でのデータアナリティクスを学ぶ必要があります。   学生の方であれば今後、卒業研究やコンペティション参加など、多くの場面で統計学の知識が必要になるかと思います。数日学習を行えば統計学への理解が深まるだけでなく、SASから学習認定デジタルバッジを無料でもらうこともできます。ぜひこの機会に一度統計学について、学習を行ってみてはいかがでしょうか?

1 4 5 6 7 8 26