Author

小林 泉
RSS
Senior Manager, Analytics Platform and Cloud Solution, Customer Advisory Division

1999年SAS Institute Japan入社後、金融・通信・製造・小売・官公庁を中心に顧客分析やサプライチェーン最適化などのアナリティクス・プロジェクトにて、データウェアハウスやアナリティクス・プラットフォームの設計/構築からアナリティクスのコンサルティングを担当。その後、プリセールスとしてSASアナリティクス・ソリューションの提案、顧客のデータ・マネージメント課題解決への従事、最新技術を利用したビッグデータ活用やSAS on Hadoopビジネスの立ち上げ、普及活動に従事。 データのリアルタイム分析と、大規模分析基盤アーキテクチャ、機械学習についての豊富な知見、経験を持つ。 2016よりSAS Viyaの立ち上げを担当し、OSSの世界へ新しい価値を提供するビジネスを推進。2020年からSAS Cloudソリューションの推進を担当。最近の興味は、「現実世界のデジタライゼーションの限界と展望」。

SAS Events | Students & Educators
小林 泉 0
筑波大学学生によるAnalytics Experience 便り(1日目)

現地時間 2017/9/18,19,20 にてSASの秋のグローバルイベントである、「Analytics Experience 2017 (以下AX2017)」がアメリカ合衆国ワシントンDCで開催中です。今回は、日本から参加している筑波大学理工学群社会工学類経営工学主専攻4年生の村井諒さん,小林大悟さん,白鳥友風さん3名による参加レポート1日目を掲載します。 Academic Summit@AX2017 レポート by 筑波大学学生 今回私たち3人が参加しているAX2017の1日目は、AM11:00にスタートしたGeneral Sessionをはじめ、様々な講演が行われました。 中でも最後時間帯である19:00から催されたAcademic Summitについてご紹介させていただきます。 Academic Summitは、AX2017に出席しているデータサイエンスに精通する学生が、学生間や企業の方々との交流を深めるイベントです。このサミットでは、SAS Executive Vice President およびSAS Chief Technology OfficerであるDr.Oliver Schabenberger氏の基調講演や、Gather IQという、クラウドソーシングによってあるトピックに関する問題の解決を図るアプリの説明、女性の技術職としてのキャリアを支援する制度、学生によるアナリティクスのコンテストであるShootout Competition における入賞チーム3組についての紹介がされ、最後に自由な交流の時間が設けられました。 Schabenberger氏は純粋数学を学んだのち、データサイエンスの道へと進むことになった経緯や、現在SAS社が注目しているAmbient AnalyticsとDeep Learningについての説明、さらに自分自身を成長させるための教訓などをお話ししてくださいました。 またGather IQは、SAS社のミッションの一つである社会貢献のためのアナリティクスの価値を非営利で提供するということを体現していたと感じました。 このイベントの最後には自由にコミュニケーションをとる時間が設けられ、参加者の皆様は積極的に情報交換を行っていました。何より印象に残ったのは、同年代で飛び級で大学院に進学した人や、SASR Enterprise Minerを使いこなしモデリングを行っていた人がいたこと、さらに、参加者全員が英語で円滑にコミュニケーションを行っていたことです。 同年代の海外の学生たちがデータサイエンスに対して抱いている思いや、それに臨んでいく姿勢、自身のキャリアに対する考えなどを聞くことで、自分たちがこれからどうやってこの分野で戦っていくべきなのか、そのために何をするべきかなど、改めて深く考えさせられました。 また、意見交換をした際、私たちは英語の能力が十分でなかったということ以前に、初対面の人に話しかけることを躊躇してしまい、インターナショナルな場で積極的にコミュニケーションをとることの難しさを痛感しました。このようなためらいを減らし、自分から積極的に意思疎通を図っていくことの大切さを感じました。 残る二日間、データサイエンスに関する知識やノウハウだけでなく、グローバル人材にとって必要な素養も学んでいけたらと思います。  
Machine Learning
小林 泉 0
機械学習のパラメータをオートチューニングしよう(回帰編)!

先日投稿した「機械学習のパラメータをオートチューニングしよう(分類編)!」の続きです。 今回は回帰分析をオートチューニングします。 あらまし 機械学習の課題はパラメータチューニングで、手動で最高のパラメータを探そうとすると、とても時間がかかり効率的ではありません。 SAS Viyaではパラメータチューニングを自動化するオートチューニング機能を提供しています。 オートチューニング機能を使うことで、限られた時間内、条件下で最高のパラメータを探索し、予測モデルを生成することができます。   今回やること 今回はオートチューニングを使って数値予測モデルを生成します。 使うデータは架空の銀行の金融商品販売データです。顧客の取引履歴と営業履歴から構成されており、新たな金融商品の販売数を予測するデータとなっています。 内容は以下のようになっており、約5万行、22列の構成です。 1行1お客様データとなっていて、顧客の口座情報や取引履歴、営業履歴が1行に収納されています。 ターゲット変数はcount_tgtで、これは各顧客が購入した金融商品数を表しています。 ほとんどが0(=未購入)ですが、購入されている顧客の購入数を予測するモデルを生成します。 今回はランダムフォレストを使って予測したいと思います。 ランダムフォレストは別々の決定木を複数作り、各決定木の予測値をアンサンブルして最終的な予測値とする機械学習の一種です。   まずは手動で予測 SAS Viyaでランダムフォレストを使って予測モデルを生成するにあたり、まずはCASセッションを作ってトレーニングデータとテストデータをインメモリにロードします。 # PythonからCASを操作するためのSWATライブラリをインポート import swat   # 接続先ホスト名、ポート番号、ユーザー名、パスワードを指定 host = "localhost" port = 5570 user = "cas" password = "p@ssw0rd"   # mysessionという名称のCASセッションを作成 mysession = swat.CAS(host, port, user, password)  

Machine Learning
小林 泉 0
機械学習のパラメータをオートチューニングしよう(分類編)!

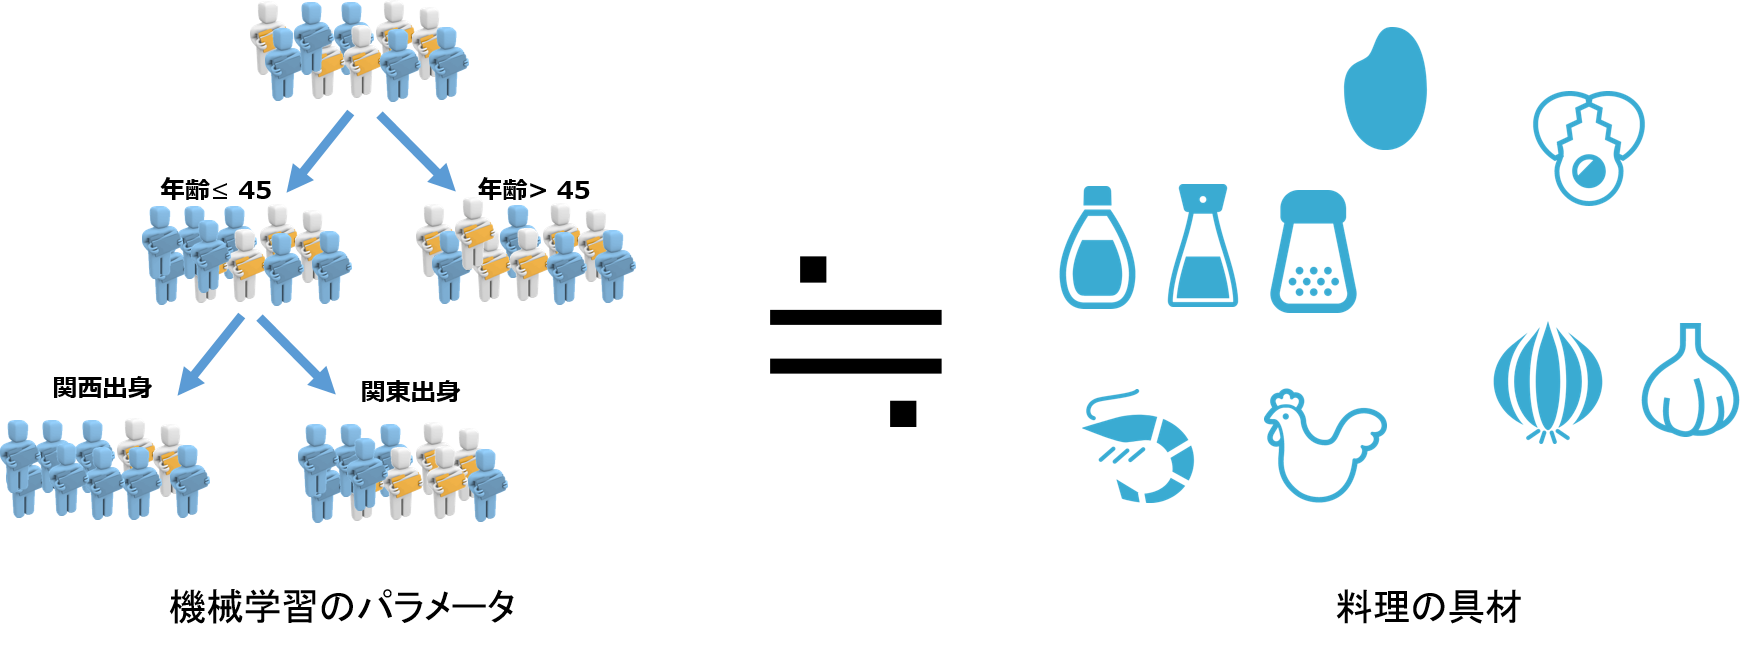
機械学習で予測モデルを作るとき、課題のひとつにパラメータのチューニングがあります。 パラメータとはどういう設定値や制限値で機械学習の予測モデルを作るのかを示すものです。 料理に例えると、チャーハンを作る過程が機械学習のアルゴリズムだとすると、どういう具材をどのくらいの量入れるのかがパラメータです。 お米の品種や卵の有無、豚肉か鶏肉か、調味料の種類や量がパラメータになります。チャーハンの良し悪しはこれらパラメータの良し悪しに左右されます。おいしいチャーハンを食べるためには、具材をベストな組み合わせと量で投入する必要があります。 昼食においしいチャーハンを食べたので、チャーハンでたとえました。 話を戻すと、機械学習の決定木の深さであったり、ニューラルネットワークのニューロン数であったり、パラメータは自分で設定する必要があります。機械学習では複数のパラメータを組み合わせて、ベストなレシピを作らねば良い予測モデルは作れません。   SAS Viyaでは各種機械学習アルゴリズムを提供していますが、各機械学習にそれぞれのパラメータが用意されています。料理に例えると、メニューにチャーハンのみならず餃子、ラーメン、寿司、ステーキ、チーズケーキがあるようなものです。シェフ(≒データサイエンティスト)は全てのベストなレシピ(≒パラメータ)を探索せねばならず、労力がいります。 しかし! SAS Viyaには更に便利な機能として、オートチューニングというものが用意されています。 オートチューニングは最も良いパラメータを短い時間で探索してくれる機能です。料理に例えると、究極のチャーハンレシピをViyaが自動的に作ってくれる機能です。夢のようですね。 オートチューニングでは機械学習のパラメータを変えながら複数の予測モデルを作り、最も良い予測モデルのパラメータを探してくれるというものです。決定木だけでもパラメータは10種類以上あるのですが、それらの最良な値をみつけてくれます。 パラメータチューニングを行う際、最も安易な探索方法は各パラメータの全パターンを試すことです。全パターンを試せば、その中から最も良いものはたしかにみつかります。しかし欠点はパラメータチューニングに長い時間がかかってしまい、現実的な手法ではありません。 SAS Viyaのオートチューニングはより賢いパラメータ探索のアルゴリズムを4種類用意しています。 遺伝的アルゴリズム(Genetic Algorithm, GA):パラメータを遺伝子と見立てて、淘汰、交叉、突然変異を組み換えすことでパラメータを探索する。 ラテン超方格サンプリング(Latin HyperCube Sampling, LHS):層別サンプリングの一種で、各パラメータをn個の区間に分割し、区間からランダムに値を取り出してパラメータを探索する。 ベイズ最適化(Bayesian Optimization):説明変数と予測の間にブラックボックス関数があると仮定し、ブラックボックス関数のパラメータの分布を探索する。 ランダムサンプリング(Random Sampling):ランダムにパラメータの値を選択して探索する。 探索アルゴリズムを詳しく説明していると終わらないので説明を短くまとめました。SAS Viyaではいずれかのアルゴリズムを利用してオートチューニングを実行することができます。   今回はPythonからSAS Viyaを操作して、オートチューニングを試してみたいと思います。 まずはPython SWATをimportし、CAS Sessionを生成してデータをロードします。 # PythonからCASを操作するためのSWATライブラリをインポート import swat   # mysessionという名称のCASセッションを作成 mysession = swat.CAS(host, port, user, password)   #

1 … 6 7 8 9 10 … 17